2026 年
2026-10-22
圖片辨識到郵件稽核,Mail DLP 導入 OCR 的關鍵考量
PM 部門經理 王東祈
OCR 讓圖片中的敏感資料重新納入 DLP 控管
企業透過電子郵件交換資料時,敏感內容早已不限於可複製、可搜尋的文字。客戶填寫的申請書、醫療表單、訂購單與簽核文件,經常以照片、截圖或掃描 PDF 附在信件中。這些檔案在人眼看來資訊完整,對只會讀取文字層的 Mail DLP 而言,卻可能只是一張圖片。若稽核流程沒有 OCR(光學字元辨識,Optical Character Recognition),姓名、身分證字號、電話、地址等個資即使清楚出現在畫面上,也可能沒有機會進入既有的政策判斷,進而形成合規與稽核上的漏洞。
因此,OCR 已逐漸成為 Mail DLP 是否完整的重要條件。它負責把影像中的文字轉成可檢測內容,再交由原有的個資規則、關鍵字條件與寄送政策判斷。企業不必另建一套圖片稽核流程,也能讓掃描附件和一般文件接受相近的控管。這項能力的價值很直接:減少圖片造成的稽核空白,讓敏感資料換成另一種檔案形式後,仍留在企業可看見、可處理的範圍內。
從金檢提問看圖片資料偵測的必要性
當金檢人員檢視郵件 DLP 的涵蓋範圍時,圖片檔案也是可能會被關注的項目。查核往往會進一步確認:是否已將 JPG、TIFF、PNG 等圖片類型檔案納入資料偵測與控管,以避免敏感資訊透過影像形式外洩。企業因此需要確認圖片是否納入檢查範圍,並說明使用哪些規則判斷,以及命中後如何處置。
若系統只能留下檔名、格式與寄送紀錄,金檢時仍難以證明圖片內容曾在寄出前接受檢查。企業需要讓影像文字先進入個資與關鍵字規則,再依政策執行告警、送審或阻擋,並保存辨識結果、規則命中與處置紀錄。這些資料能回答查核關心的重點:控制是否實際運作、異常如何處理,以及事後能否還原過程。
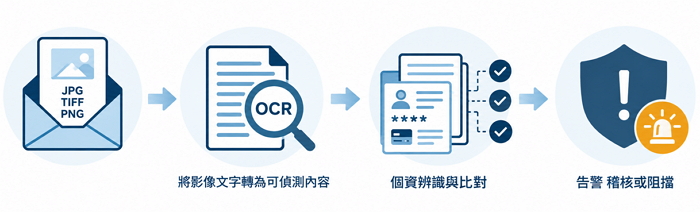
【圖一、OCR 將圖片文字轉為可檢測內容,再交由個資規則與郵件政策進行告警、稽核或阻擋】
郵件 DLP 的 OCR 需要符合治理情境
近年的 AI 視覺模型可以辨識複雜畫面,也能理解表單、物件與上下文,但郵件 DLP 評估 OCR 時,準確率並不一定是最重要的一項。企業還要確認圖片是否必須送往外部服務、處理過程能否留下紀錄、既有硬體是否足以負荷,以及辨識結果能不能直接接上原本的 DLP 政策。若只比較模型能力,很容易忽略資料路徑、成本與維運方式對日常治理的影響。
使用公開 AI 服務進行圖片辨識時,郵件或附件可能需要離開企業環境,交由第三方平台處理。不同服務對資料保存、模型訓練、處理地區與管理權限的規定各有差異;在未確認契約與技術設定前,將客戶資料、內部文件或研發內容送入外部服務,本身就可能增加新的合規問題。企業原本希望透過 DLP 降低外洩風險,若辨識過程反而讓機敏資料多經過一個不受控的環節,整體治理便失去一致性。
另一條路是自行建置大型視覺模型或 LLM 推論環境。這類架構通常涉及 GPU、儲存空間、模型更新、資安修補及專業維運人力,導入成本會隨郵件量與附件大小持續增加。對主要需求是辨識圖片文字、找出個資並套用郵件政策的企業而言,投入大型 AI 中心未必符合效益。實際評估時,更值得關注的是常見文件能否穩定解析、處理速度是否符合郵件流量、錯誤是否容易追查,以及新增能力會不會迫使企業全面更換現有設備。
企業可從五個面向檢視 OCR 是否適合郵件 DLP:圖片能否留在可控環境、辨識結果能否接上既有政策、現有 CPU 與系統容量是否足以負荷、處理與審核紀錄是否可供追查,以及核心技術來源能否符合組織的資安與採購要求。這些條件共同決定 OCR 能否穩定納入日常郵件流程。
兼顧合規成本與技術來源的實務選擇
對 Mail DLP 而言,合適的 OCR 應能完成明確任務:把常見圖片與掃描文件中的文字轉出來,讓個資和機敏內容重新進入既有稽核流程。辨識效果必須經過實際文件驗證,同時也要控制誤判、處理時間與硬體負擔。這種做法不需要讓模型理解整張圖片的所有語意,卻能把企業最在意的文字資料交回熟悉的規則引擎處理。
技術來源也開始成為採購評估的一部分。部分政府、金融與關鍵產業會進一步檢視軟體供應鏈,確認核心技術與相關元件是否符合非紅供應鏈要求,降低特定來源技術可能帶來的資安與合規疑慮。以MailAudit OCR 為例,在技術選用上即納入這項考量,核心辨識技術不採用中國來源技術,並可使用既有主機的 CPU 資源執行,不強制要求企業增購 GPU 或其他專用硬體。對需要兼顧資安政策、既有架構與導入預算的組織而言,這類設計較容易整合至現行郵件環境,也能避免為單一 OCR 辨識需求額外建置大型 AI 運算平台,在強化郵件內容辨識能力的同時,降低整體導入與維運負擔。
從門診表單測試看 OCR 如何補上個資辨識
以門診初診資料的圖片樣本為例,表單同時包含姓名、出生日期、身分證字號、聯絡電話與通訊地址。若附件只有影像而沒有文字層,傳統規則難以直接比對其中內容。經 OCR 轉換後,系統便能把辨識出的文字交給既有個資條件進行檢查。
在圖二測試中,姓名、生日、身分證字號、電話與地址五類指定個資皆成功辨識。這項結果代表同一套郵件政策可以同時處理信件文字、一般文件及圖片附件,不必因資料變成 PNG、JPG 或掃描檔就中斷。測試資料也涵蓋 JPEG、GIF、TIFF、WebP與PDF 等不同形式,用來確認常見郵件附件進入 OCR 流程後的處理情形。實際導入時,仍應以企業自身常見的文件版型、影像品質與郵件量進行驗證,再據此設定處置條件。
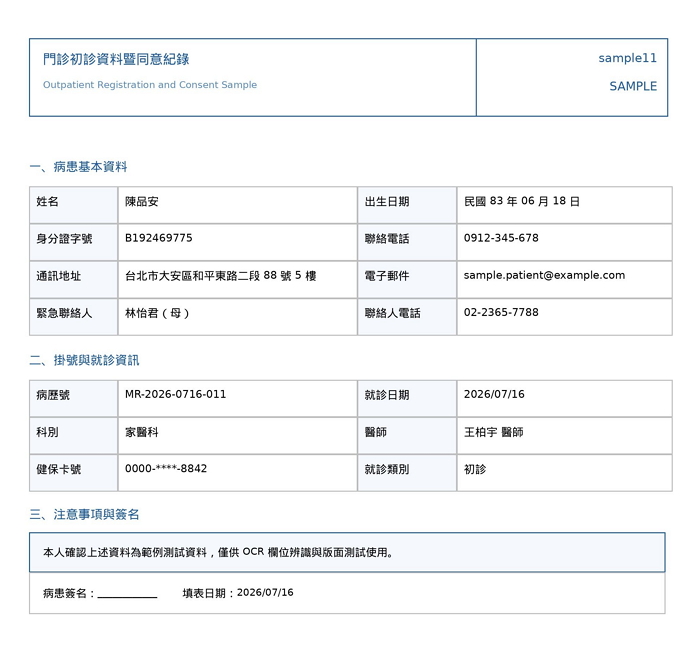
【圖二 、門診初診資料測試樣本 姓名、生日、身分證字號、電話與地址皆可被 OCR 辨識並進入個資比對】
讓 OCR 成為 Mail DLP 的基本能力
圖片與掃描文件已是企業交換資料的日常形式,Mail DLP 若缺少 OCR,便很難完整掌握郵件中的敏感內容。導入時也不宜只追逐最高辨識規格。資料是否留在可控環境、結果能否接上現有政策、硬體成本是否合理,以及查核時能否還原處理過程,都會直接影響 OCR 能不能長期運作。
以 MailAudit 的做法來看,OCR 負責將圖片文字帶回既有 DLP 流程,再由個資辨識、關鍵字政策與郵件處置機制完成後續控管。企業可以從高風險文件與常見圖片格式開始測試,觀察辨識結果和郵件效能,再逐步擴大適用範圍。當圖片附件也能接受一致的檢查、審核與留痕,Mail DLP 才能真正涵蓋企業每天透過郵件傳遞的資料樣貌。